Esta semana —la del 16 al 22 de noviembre de 2026— ha traído tres hitos que marcan direcciones distintas pero convergentes: la estandarización de la evaluación en biomedicina, el endurecimiento del escrutinio regulatorio en Europa y una carrera de rendimiento entre modelos propietarios que redefine lo que entendemos por «estado del arte».
TabBioMed: 94 datasets para poner orden en el aprendizaje tabular biomédico
El paper más destacado de la semana llega de la mano de un consorcio internacional liderado por Pau Mateo-Bernadó y David Bonet. Publicado en arXiv el 18 de noviembre (arXiv:2611.23779), TabBioMed presenta un benchmark de 94 datasets públicos curados que abarcan registros electrónicos de salud, descubrimiento de fármacos, genómica, transcriptómica, proteómica, metabolómica, ómicas de célula única y biología de sistemas.
El problema que resuelve TabBioMed es real y doloroso: hasta ahora, la evaluación de modelos de machine learning en datos biomédicos tabulares estaba fragmentada. Cada equipo usaba sus propios splits, su propio preprocesamiento y sus propias métricas, lo que hacía imposible comparar resultados entre estudios. TabBioMed unifica todo esto mediante un framework de preprocesamiento y evaluación dataset-aware que estandariza clasificación, regresión y tareas multi-target.
El estudio benchmarkea 23 modelos repartidos en cuatro familias: baselines clásicos, gradient-boosted trees (XGBoost, LightGBM, CatBoost), arquitecturas neuronales tabulares (TabNet, TabTransformer, FT-Transformer) y modelos fundacionales tabulares (TabPFN v2, TabDPT, MambaTab). La conclusión principal es matizada: los modelos fundacionales ganan en rendimiento predictivo bruto a nivel de familia, pero sus ventajas dependen del régimen de datos. En escenarios con restricciones de coste de inferencia o entrenamiento, los árboles de gradiente y los MLP bien ajustados siguen siendo extremadamente competitivos —y a menudo ganan—.
TabBioMed libera no solo los datasets y splits curados, sino también el código de preprocesamiento, los baselines y los resultados completos. Está disponible en GitHub (AI-sandbox/TabBioMed) y Hugging Face (TabBioMed), listo para convertirse en el referente de facto del campo.
Europa mueve ficha: Capgemini liderará la evaluación de riesgo cibernético de la IA avanzada
Mientras la comunidad científica estandariza benchmarks, la Unión Europea avanza en el flanco regulatorio. El 18 de noviembre, la Revista Inteligencia Artificial informó de que la Oficina de IA de la Comisión Europea ha adjudicado a un consorcio liderado por Capgemini —con Wavestone y el laboratorio francés LNE— un contrato de 36 meses para desarrollar metodologías de evaluación del riesgo de ciberofensiva en modelos de propósito general con riesgo sistémico.
El mandato nace del Reglamento Europeo de IA (EU AI Act), que entró en vigor el 1 de agosto de 2024 y aplica obligaciones específicas a proveedores de modelos de propósito general con riesgo sistémico (Artículo 55). Entre ellas: evaluación mediante protocolos estado-de-la-técnica, pruebas adversarias, gestión de riesgos sistémicos y notificación de incidentes graves.
La novedad no es que la UE regule —eso ya ocurría—, sino que encarga la construcción de la herramienta de medida. Hasta ahora, los desarrolladores publicaban model cards y declaraciones de limitaciones, pero no existía un protocolo común, reproducible y auditable para responder a la pregunta técnica central: ¿puede este modelo aumentar las capacidades ofensivas de un atacante real?
El consorcio combinará experiencia en consultoría tecnológica (Capgemini), análisis de amenazas (Wavestone) y metrología/verificación de conformidad (LNE). El objetivo: transformar preguntas vagas sobre «IA segura» en procedimientos de prueba comparables, repetibles y documentados —escenarios definidos, indicadores de éxito, límites seguros, recursos entregados al sistema, número de intentos, papel de operadores humanos—.
Es un paso necesario. Como señala el artículo, un modelo que destaca en un ejercicio de seguridad defensiva no es necesariamente más peligroso que otro; el riesgo depende de su disponibilidad, barreras de acceso, capacidad de actuación y posibilidades de uso indebido. Tampoco resultados negativos en un conjunto limitado de pruebas demuestran ausencia de capacidades problemáticas. La seguridad requiere seguimiento continuo, no una certificación única basada en una fotografía tecnológica que envejece en meses.
Lo mejor de arXiv esta semana: eficiencia, video y agentes
El ArXiv TLDR de la semana del 16 de noviembre (2026-W47) destaca 10 papers que dibujan las tendencias de fondo: eficiencia práctica, simplificación arquitectónica y evaluación robusta de agentes. Tres merecen mención especial:
1. JVT: Just Video Transformer — difusión de video en espacio de píxeles sin autoencoders
El paper #1 de la semana (cs.CV) presenta JVT, una arquitectura Transformer estilo DiT para difusión de video directamente en espacio de píxeles, eliminando la necesidad de autoencoders complejos (VAE). Analiza sistemáticamente patch embeddings, register tokens y normalización, y permite generación conjunta de modalidades alineadas a píxel (RGB, disparidad, profundidad). Simplificar el pipeline de video generativo reduce coste computacional y puntos de fallo —una dirección que el campo perseguía desde hace años.
2. MMFlash: Decodificación especulativa adaptativa para modelos visión-lenguaje
El #2 (cs.CV) ataca el cuello de botella de latencia en VLMs. MMFlash usa adaptive drafting y sparse attention para acelerar la generación. Introduce una métrica basada en divergencia KL para medir dependencia visual a nivel de token, y upweighta adaptativamente los tokens visuales mal predichos. La atención dispersa reduce redundancia en entradas de video largo. Resultado: generación más rápida sin perder calidad en tareas multimodales.
3. HerAgent: Checkpointing a nivel de bloque para agentes de código
El #6 (cs.SE) resuelve un problema práctico doloroso: la configuración de entorno de agentes de coding es frágil y cara. HerAgent introduce semantic setup blocks (ejecución, validación, checkpointing, rollback) que elevan la tasa de éxito en Installamatic-Bench al 85 % y reducen costes de setup hasta un 94,5 % frente a agentes baseline. Es infraestructura invisible, pero infraestructura que hace que los agentes pasen de «demo interesante» a «herramienta usable en producción».
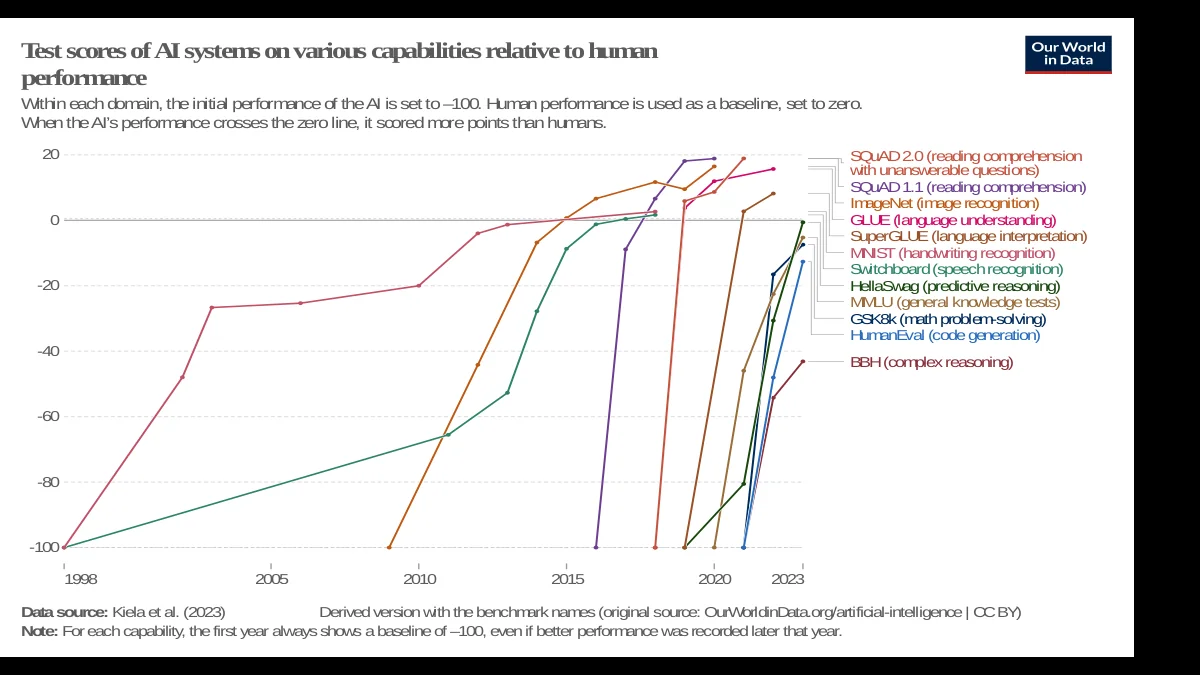
El panorama de benchmarks a 20 de noviembre de 2026: Claude Fable 5.2 domina, pero la competencia aprieta
La actualización de Metix (16 de noviembre) y los índices de Artificial Analysis (v5.0 desde el 28 de octubre) y Arena dibujan un mapa claro: Claude Fable 5.2 (Anthropic, presentado el 9 de noviembre) es el modelo a batir en noviembre de 2026.
| Benchmark | Líder | Nota clave |
|---|---|---|
| Artificial Analysis Intelligence Index v5.0 | Claude Fable 5.2 (65 pts) | 5 pts sobre Gemini 4 Carbon; coste tarea máx: $26,54 |
| LiveBench | Claude Fable 5.2 | Trabajo real y preguntas cortas |
| ARC-AGI-3 (arnés estándar) | Claude Fable 5.2 (81,2 %) | Juegos nuevos sin instrucciones |
| Terminal-Bench 4.0 (Vals) | Fable 5.2 = Opus 5.5 (65,15 %) | Empate técnico; Kimi K3.1 Pro 4º a 0,5 pts |
| Arena (agentes) | Claude Fable 5.2 | 10.406 sesiones; margen asegurado |
| Arena (desarrollo web) | Claude Fable 5.2 | Empate estadístico con Opus 5.5 |
| Arena (texto) | Gemini 4 Carbon (4.273 votos) | Intervalo de confianza se solapa con Argon |
| Mejor modelo abierto (Artificial Analysis) | Kimi K3.1 Pro (46 pts) | Pesos publicados; cuesta $2/10 por M tokens |
Claves de lectura:
- El liderazgo de Fable 5.2 se paga caro: en Artificial Analysis, esfuerzo máximo cuesta $26,54/tarea y 4 min de latencia; esfuerzo alto baja a $9,08 y <30 seg. La pregunta no es solo «quién gana», sino «a qué coste y latencia».
- SWE-bench Verified está saturado (97 % Opus 5); la referencia de coding real ha pasado a Terminal-Bench 4.0 (66 tareas largas, mediana 4 h experto).
- Los modelos abiertos avanzan: Kimi K3.1 Pro (Moonshot, 24 oct) es el mejor abierto en Artificial Analysis y Terminal-Bench; DeepSeek V4.1 Flash 1017 (33 pts) lidera LiveBench entre abiertos a $1,20/M tokens salida; MiMo-V2.6-Pro (Xiaomi) es el mejor abierto en Arena texto (puesto 14 global).
- Gemini 4 Hydrogen (12 nov, $1,50/7,50 por M tokens) democratiza la familia Gemini 4: 54 pts en Artificial Analysis, gratis en app Gemini y buscador.
- GPT-6 Astra/6.1 Sol/Terra (OpenAI) muestran la estratificación por precio: Astra (57 pts, caro), Sol (55 pts, 1/5 precio), Terra (51 pts, $1/5, mejor valor coding con Codex: 48,6 pts a $1,53/tarea).
Otras señales de la semana: DNA pretraining, retrieval eficiente y robótica sim-to-real
El top-10 de ArXiv TLDR completa el cuadro con avances transversales:
- Sequence Pruning (#4, q-bio.GN): dynamic pruning de secuencias de DNA fáciles de predecir durante pretraining —96 % menos procesamiento sin perder rendimiento downstream. Supera a InfoBatch y BPAS.
- LAAM (#5, cs.IR): active learning para aproximar juicios de relevancia de LLM en retrieval de queries largas —97 % menos energía, 87 % del DeepSeek P@10 con solo 3,3 % del coste energético (TREC Robust 2004).
- Support-Gated World Models (#7, cs.AI): modelos de mundo clínicos que withholdean simulaciones de paciente no fiables para decisiones de vasopresores de alto riesgo. Evaluados en 30.700 transiciones / 70 hospitales (eICU-CRD).
- PEAR (#8, cs.RO): motor de RL en simulación para razonamiento robótico —74,4 % éxito en LIBERO, 60 % en robots dual-arm reales sin degradación del modelo base. Generaliza a robots, instrucciones y mundo real no vistos.
- DiSPaT (#9, cs.LG/cs.CL): f-divergence self-play fine-tuning para detección de anomalías tabulares con LLMs. Cierra brecha distributiva mediante optimización alternada policy/critic generando pseudo-anomalías.
- Heavy Metal Acrobatics (#10, cs.RO): RL en simulación para skid-steer loader de 5 toneladas —equilibrio y conducción en dos ruedas con transferencia sim-to-real exitosa. Control dinámico de maquinaria pesada.
Conclusión: medir para avanzar, regular para confiar
La semana del 16 al 22 de noviembre de 2026 deja tres lecturas complementarias:
-
La evaluación se profesionaliza. TabBioMed demuestra que, en un dominio tan crítico como la biomedicina, la fragmentación de benchmarks frena el progreso. Un benchmark bien diseñado —datasets curados, preprocesamiento estandarizado, splits fijos, baselines reproducibles— es infraestructura científica, no papeleo. Lo mismo ocurre en coding (Terminal-Bench), agentes (Arena agentes) y evaluación general (Artificial Analysis v5.0).
-
La regulación construye sus propias herramientas de medida. El encargo UE-Capgemini-LNE-Wavestone señala que el AI Act no se conforma con model cards: quiere protocolos de prueba adversaria comparables, repetibles y auditables. Es el paso de «confiad en nosotros» a «demostradlo bajo estas condiciones». La metrología (LNE) entra en el juego de la seguridad de IA —una señal de madurez del campo.
-
La carrera de modelos tiene matices que los rankings ocultan. Fable 5.2 gana en 7 de 9 benchmarks, pero su ventaja es a menudo marginal, estadísticamente no significativa o prohibitivamente cara. Los modelos abiertos (Kimi, DeepSeek, MiMo, GLM) recortan distancias en tareas concretas y ofrecen value-for-money inalcanzable para los propietarios. La elección real no es «el mejor», sino el mejor para tu presupuesto, latencia y caso de uso.
Mientras tanto, arXiv sigue entregando papers que resuelven problemas de ingeniería real: video sin VAE, decoding especulativo multimodal, checkpointing de agentes, pruning de DNA, retrieval energéticamente eficiente, robótica sim-to-real. Esa es la investigación que, silenciosamente, hace que la IA de mañana sea más rápida, barata y usable.
Artículo basado en: TabBioMed (arXiv:2611.23779, 18 nov 2026); Revista Inteligencia Artificial «Europa prepara nuevas pruebas para evaluar los riesgos de los modelos avanzados de IA» (18 nov 2026); ArXiv TLDR Weekly 2026-W47 (16 nov 2026); Metix «Benchmarks de IA hoy: ranking actualizado noviembre 2026» (actualizado 16 nov 2026). La información refleja el estado de la investigación y los benchmarks a fecha de publicación.